퓨처 시그널
속도가 너무 빠르다. AI 기술은 빠르게 발전하며 우리의 일과 생활에 들어오고 있다. AI가 사람의 일을 어디까지 돕고, 어떤 역할을 대신하게 될지는 이제 먼 미래의 이야기가 아니다. 세상을 보고 듣는 AI, 시키지 않아도 움직이는 AI, 마침내 몸을 얻어 실세계로 나아가는 AI. 이미 보이기 시작한 세 가지 풍경은 우리의 삶이 어떻게 바뀔지 가늠하게 해 준다.
세상이 먼저 말을 걸어오는 순간
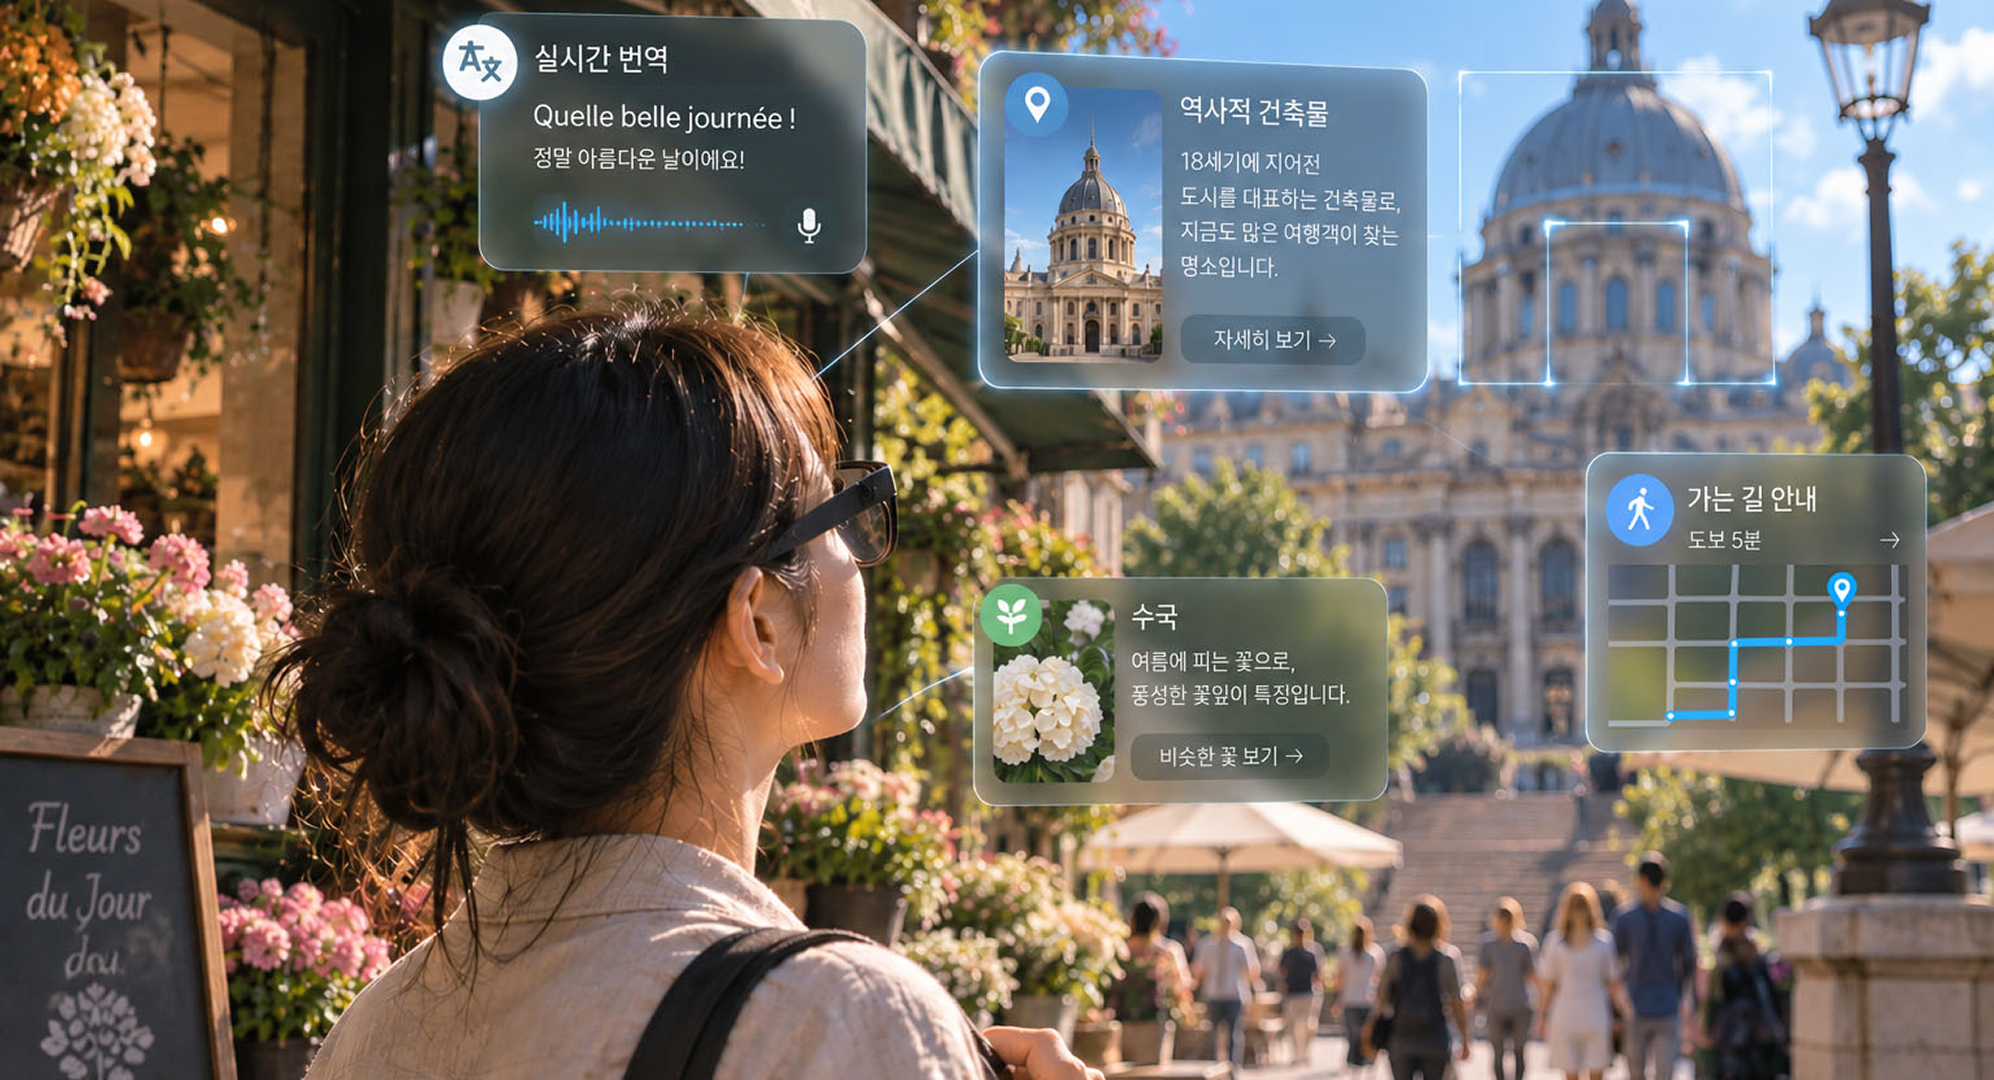
스마트폰이 일상의 중심 기기가 된 지 오랜 시간이 흐르면서, ‘포스트 스마트폰’, 그러니까 스마트폰 이후의 무언가를 찾아 헤맸다. 두 손을 자유롭게 할 ‘웨어러블’은 늘 유력 후보였다. 최근 여러 글로벌 기술 기업이 공을 들이고 있는 분야가 바로 스마트 안경이다. 확장현실(XR) 스마트 안경이라면 스마트폰을 보완하는 보조 화면이 아니라 독자적인 생태계의 중심이 될 수 있을지도 모른다고 생각하기 시작했다.
이런 변화의 배경에는 시각과 청각을 함께 이해할 수 있는 ‘멀티모달(Multimodal) AI’가 있다. 멀티모달 AI는 텍스트, 이미지, 음성, 영상 등 다른 형태의 데이터를 동시에 이해하고 처리하는 기술이다. 스마트 안경과 결합하면 사용자가 보고 듣는 주변 상황을 AI가 함께 인식하고 필요한 정보를 제공하는 방식으로 활용될 수 있다. 스마트폰이 우리에게 24시간 언제나 인터넷에 연결되는 ‘올웨이즈 온(Always On)’의 생활 감각을 알려줬다면, 스마트 안경은 내 앞에 펼쳐진 이 세상이 실시간으로 AI와 동기화되는 것이다.
여행지에서 보고 듣는 모든 걸 통번역해 주는 일쯤 쉽게 생각할 수 있는 초보적 활용 사례다. 그 정도 지능이 늘 내 얼굴 위에 있다면, 이 세상 삼라만상은 적극적으로 상호 작용할 수 있는 호기심 천국이 된다. 카톡을 보낼 수도 있고 받을 수도 있듯 ‘올웨이즈 온’의 참맛은 쌍방향에 있다.
이제 세상이 내게 말을 걸어 올 수 있다. 풀밭의 꽃도 그 유래와 꽃말로 말을 걸 수도 있고, 냉장고 문을 열면 식자재를 서로 조합해 오늘의 메뉴를 추천해 줄 수도 있다.
정보란 이제 앱을 열고 메뉴를 찾아 들어가 검색해 끄집어내는 능동적 노동의 결과가 아니라, 내가 놓인 수동적 맥락에 맞게 세상에서 쏟아져 내리는 공기나 물 같은 삶의 원소가 된다. 챗GPT의 등장 이래 각종 앱과 웹의 사용이 줄었다고 한다. 이미 AI는 단일 인터페이스가 되고 있었다. 스마트 안경과 같이 두 손이 자유로워지는 인터페이스라면 그 자리를 차지할 수 있다.
오늘의 신호, 내일의 풍경 ①
지금 여기까지
변화의 신호
다음 풍경
시키기 전에 움직이는 AI 집사
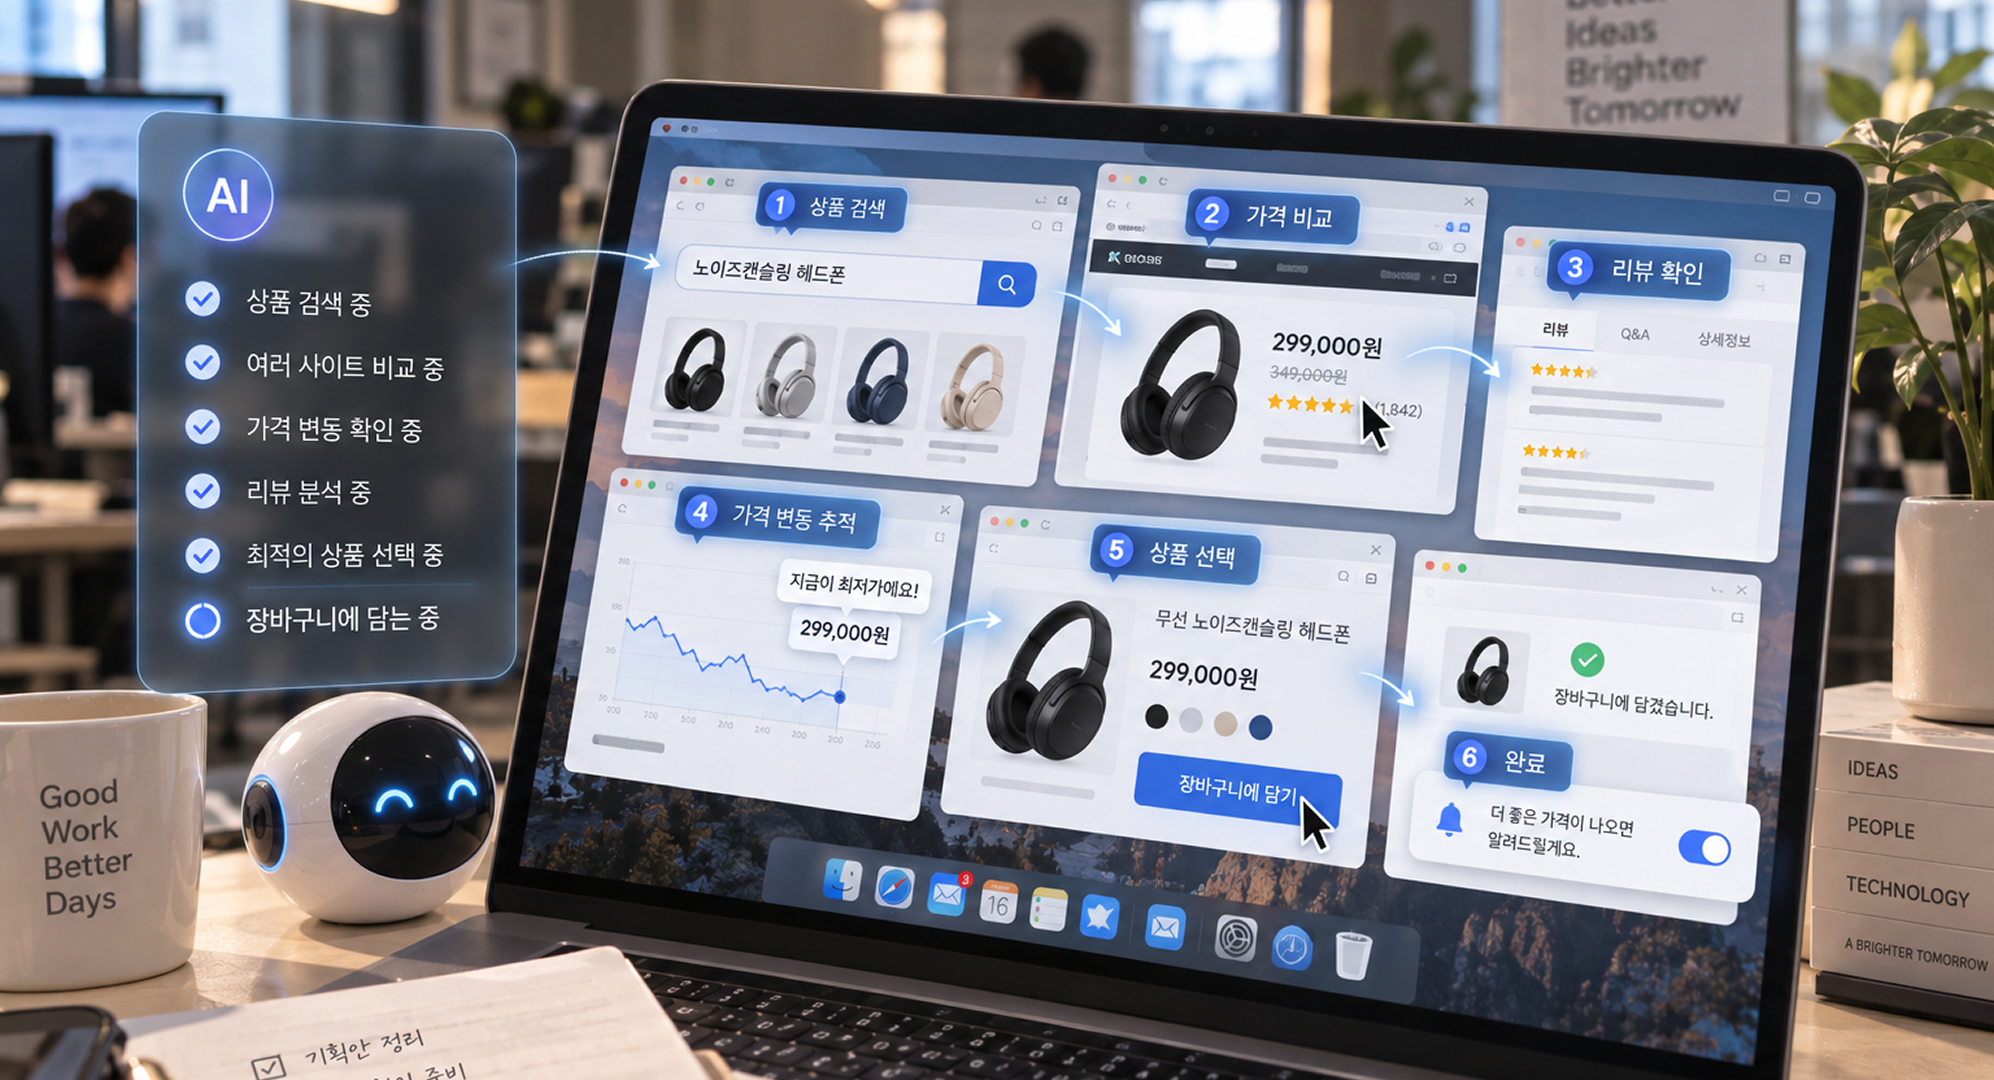
쇼핑은 즐거운 일이기도 하지만 은근히 피곤한 일이다. 최애 아이템을 훑어보는 건 설렐 수도 있다. 그러나 기껏 발품·손품 팔아 가며 산 제품이 다른 곳에서 세일 중이라거나, 받고 나니 사양이 내가 생각했던 것이 아니라거나. 어떤 날은 “이걸 놓쳤네!”라고 부르짖고 싶을 정도로 아쉬워지기도 한다. 굳이 이럴 일인가. 이런 아쉬움을 AI 에이전트, 그러니까 인공 대리인은 해소해 주기 시작하고 있다.
내 취향에 맞는 제품을 늘 탐색하고 있다가 알아서 장바구니에 살포시 담아 둔다. 내가 눈팅만 하고 있던 제품이 최저가를 찍으면 재빨리 알려 주기도 한다. 구글이 선보인 유니버설 카트나 퍼플렉시티의 쇼핑 기능이 약속하는 미래다.
챗봇과 AI 에이전트,
뭐가 다를까?
CHATBOT
 답하는 AI
질문이나 명령을 받는다
필요한 정보를 찾아 답을 만든다
요청받은 범위에서 응답한다
사용자에게 답을 알려준다
AI AGENT
 행동하는 AI
사용자의 목표와 의도를 이해한다
필요한 정보와 작업을 스스로 찾는다
여러 단계를 이어서 수행한다
사용자를 대신해 행동한다
사실 우리가 기대하는 건 이보다 진일보한 시나리오다. 처음 보는 쇼핑몰이라도 그 쇼핑몰의 웹페이지나 앱을 알아서 AI가 대신 수시로 들락날락하면서 가격을 추적하고 비교하고 리뷰를 확인할 수도 있다. AI가 만약 인간과 똑같이 눈을 가지고 인간이 쓰는 웹이나 앱을 그대로 쓰면 벌어질 수 있는 일은 상상력을 자극한다. 이미 그 초보적 모양새가 ‘컴퓨터 유스(Computer Use)’, 그러니까 컴퓨터를 직접 조작하는 기능으로 만들어지고 있다. 그렇다면 앞으로는 그 어떤 컴퓨터 작업도 대리해 줄 수 있다. 쇼핑쯤이야 우스울 것이다.
미래의 에이전트는 주인이자 소비자인 나를 위한 복무를 최우선으로 한다고 가정해 보자. 현재는 제휴나 연동, 협업을 통한 매치메이킹에 의한 쇼핑 에이전트가 선보이고 있는 단계지만, 그러한 주어진 기능이나 설정 없이도 AI 집사는 쇼핑이라는 의도를 순수하게 대행할 수 있다. 그렇다면 보통 제휴될 리 없는 긴장감 있는 각종 구매 행위, 각종 ‘티켓팅’ 등에 AI가 동원될 수도 있다. 최애 아티스트의 콘서트는 물론, 대작 영화의 아이맥스 티켓, 연휴의 공공시설 예약 등 쇼핑몰이 아니라도 웹과 앱을 나 대신 총동원해 주인의 의지를 실현해 주는 ‘매크로’ 에이전트도 언젠가는, 아니 어쩌면 이미 등장했을 수도 있다. 다만 미래는 모두에게 공평히 찾아온 것이 아닐 뿐.
오늘의 신호, 내일의 풍경 ②
지금 여기까지
변화의 신호
다음 풍경
AI가 화면 밖으로 걸어 나올 때
AI의 가공할 발전 속도가 “이게 되네…”의 시대를 열어젖힌 것은 맞지만, 아직 넘어야 할 큰 벽이 있다. 바로 실세계라는 벽이다. 아직 AI는 언어 안에 갇혀 있다. AI가 멀티모달로 세계를 인식하고 해석해 결과를 ‘생성’하더라도, 아직은 우리의 육신이 그 AI를 대신해 결과물을 제본도 하고, 제출도 하고, 프레젠테이션도 해야 한다. 우리의 몸은 AI의 지시를 대행해야 했다. 챗봇이 알려준 레시피를 받아 들고 서둘러 주방에 가서 냄비를 꺼내야 했다.
생성형 AI, LLM 등 근래 우리를 놀라게 했던 수많은 AI의 혁신은 인간의 언어라는 기호 처리를 기본으로 한다. 입출력이 기호로 표현될 수 있고, 그 기호는 인간의 언어이므로 어디서나 쓰이고 또 호환될 수 있다. 인간의 기호는 그렇게 편리하다. 그러나 실제 물리적 세상은 인간의 기호로 이루어져 있지 않다. 인간이 자신의 감각으로 이를 해석하고 기호로 추상화하고 있을 뿐이다. 그 기호의 산출물로 세계를 움직이는 건 오롯이 인간의 몫이었고 아직도 그렇다.
자율주행처럼 실세계를 입력받아 실세계에 대한 반응을 즉시 출력해야 하는 ‘피지컬 AI’의 발전이 LLM 등에 비해 느린 이유는 바로 이 때문이다. 기계 각각이 세계를 인식하는 일은 인간의 언어와 같은 공통 기호로 이뤄지는 것이 아니다. 센서라는 물리적 하드웨어가 공간 데이터를 어떻게 최종 생성할지, 그 전 과정에서 아직도 시행착오를 겪고 있다. 자율주행 기업 웨이모의 과도기적 처리 방식은 그 극복을 위한 힌트를 준다. LLM은 기본적으로 다음 단어를 예측한다. 마찬가지로 실세계에서 필요한 것이 다음 순간에 대한 예측이라면, 지금을 묘사해 말해주면 LLM이 그다음 순간을 묘사할 수 있다. 중얼거리듯 세계를 번역하고 세계에 반응한다.
AI는 어떻게
실세계로 나아갈까?
언어의 패턴을 학습
다음 단어를 예측
이미지·소리·영상
등을 함께 인식
주변 상황을 이해
세계가 어떻게
움직이는지 학습
다음 상황을 예측
실세계의 정보를
입력받아
판단하고
물리적으로 행동
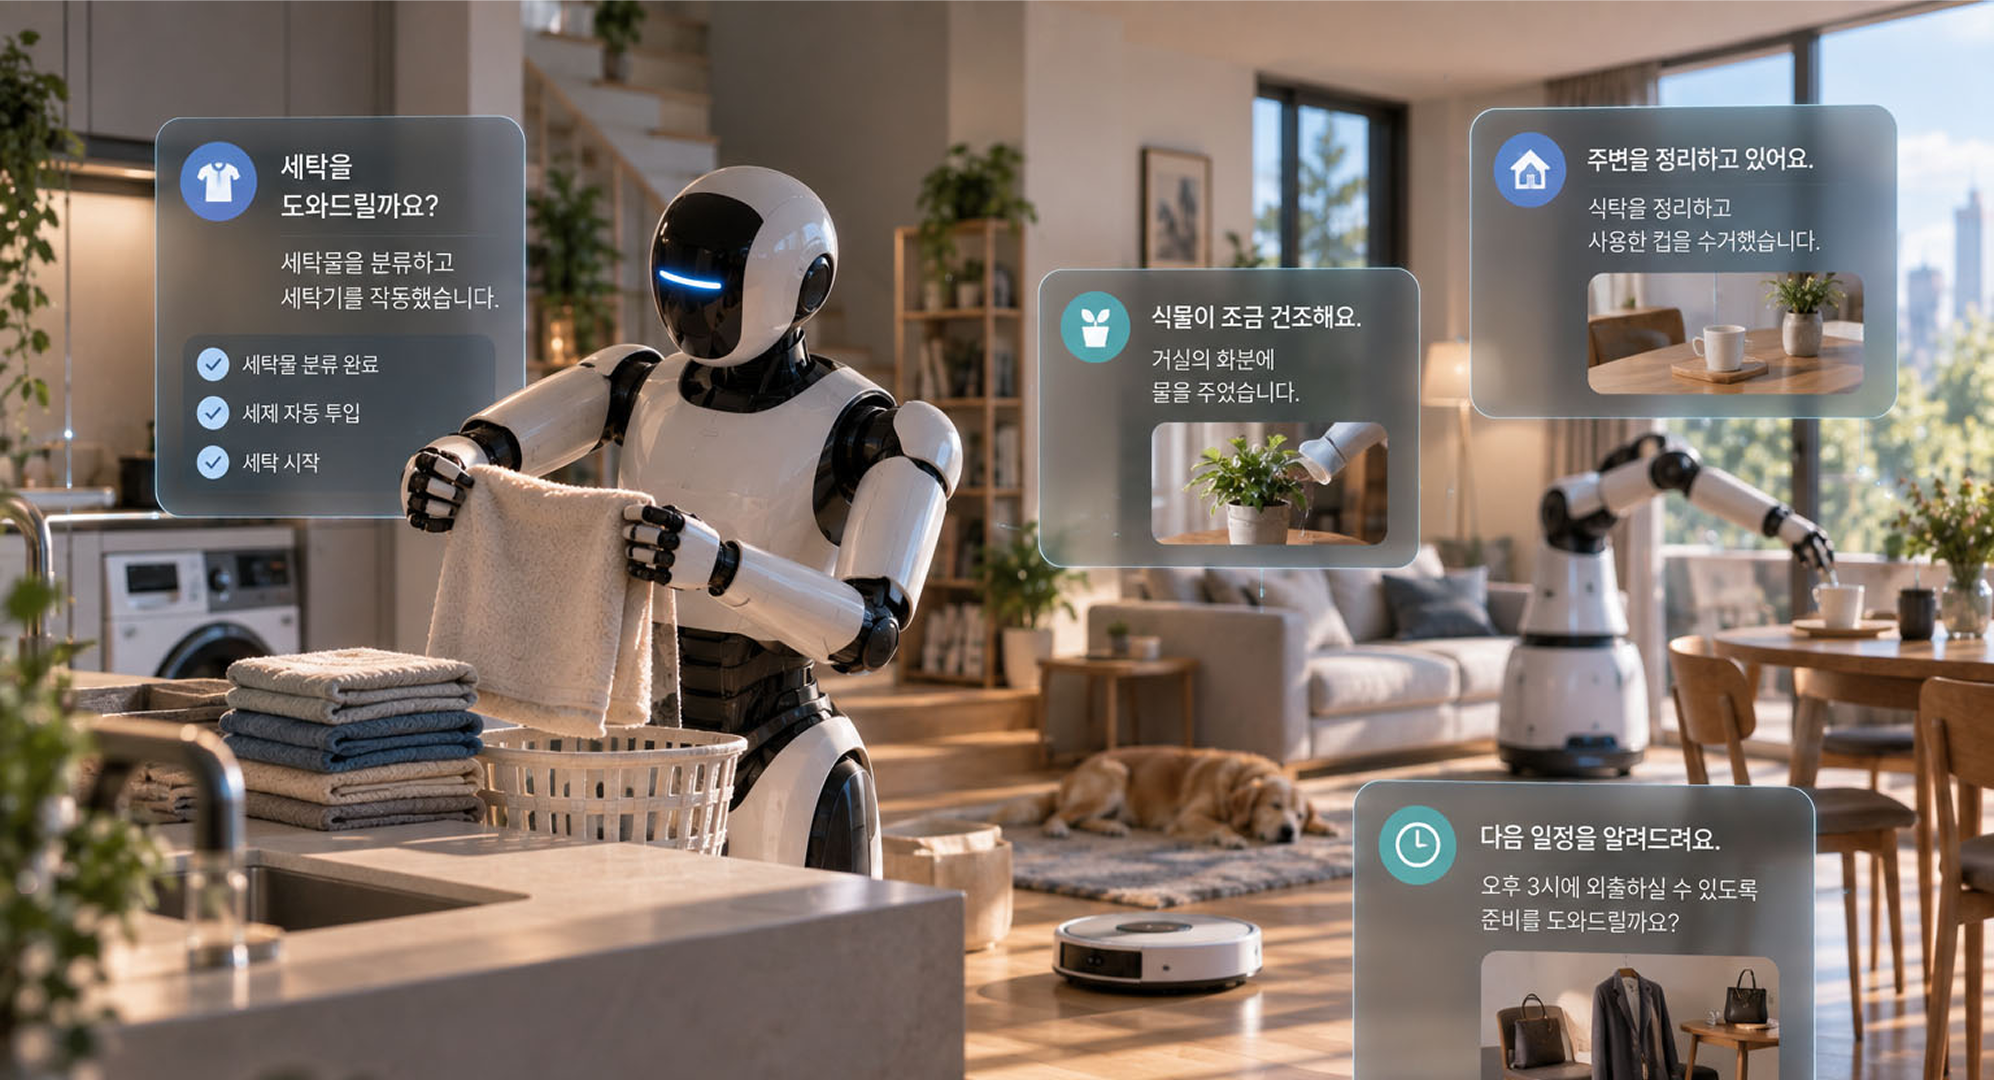
이미 휴머노이드는 우사인 볼트보다 100m를 빠르게 달리고 하프마라톤을 신기록으로 완주했다. 로봇 하드웨어의 발전은 이처럼 무섭다. 그러나 결승선 뒤에는 충돌 방지 쿠션이 설치되어 있고, 트랙에는 달리다가 폭주해 널브러진 잔해가 그대로다. 뇌가 없는 듯, 중력 같은 기본적인 물리적 감이 없이 행동한다. 가사 로봇도 빨래를 갤 수 있지만, 그 몸무게와 덩치로 영 요령 없이 일을 하니 답답하다.
하지만 큰 변화가 곧 올 수 있다. 언어가 아닌 실세계를 학습한 본격적인 ‘월드 모델’을 만들려는 시도가 곳곳에서 벌어지고 있어서다. 2023년의 ‘챗GPT 모먼트’처럼 누군가 그 벽을 뛰어넘는다면, 급속히 실생활에 AI가 뛰어들 것이다. 진짜 가사를 대신하고, 운전과 배달을 대신하고, 경비를 서고, 더 치명적 임무도 대신할 수도 있다. AI의 맥락이 이처럼 기호를 넘어 삶의 공간으로 확장될 때 AI는 인간을 대체할 정도의 영향력을 갖게 된다. 우리는 지금 그 코너에 서 있다.
오늘의 신호, 내일의 풍경 ③
지금 여기까지
변화의 신호
다음 풍경